Infrastruktura IT / Wirtualizacja · Poradnik · ok. 9 min
Wysoka dostępność serwerów – jak zapewnić ciągłość działania infrastruktury IT?
Alterkom – Zespół Technologiczny. Klastry HA, redundancja serwerów, sieci i storage, RPO/RTO oraz Disaster Recovery — bez mylenia HA z backupem.
Awaria pojedynczego serwera nie musi oznaczać zatrzymania pracy przedsiębiorstwa. Odpowiednio zaprojektowana infrastruktura High Availability (HA) pozwala ograniczać skutki awarii sprzętu, systemów i usług, a w wielu scenariuszach automatycznie przywracać działanie aplikacji na innych zasobach.
Wysoka dostępność serwerów wymaga jednak znacznie więcej niż zakupu dwóch maszyn. O jej skuteczności decyduje cała architektura, sposób zarządzania zasobami oraz regularne testowanie procedur awaryjnych.
Spis treści
VMware, Hyper-V czy Proxmox VE?
High Availability a Disaster Recovery
RPO, RTO, błędy i plan wdrożenia
Czym jest High Availability?
High Availability to podejście do projektowania systemów informatycznych, którego celem jest ograniczenie czasu niedostępności usług i zapewnienie ciągłości działania IT.
Typowe rozwiązanie HA wykorzystuje nadmiarowe zasoby, monitoring stanu środowiska oraz mechanizmy przełączania usług (failover cluster) w przypadku awarii.
Przykładowo klaster wirtualizacyjny (VMware, Hyper-V lub Proxmox HA) może uruchomić maszynę wirtualną na innym hoście, jeśli serwer, na którym wcześniej działała, ulegnie awarii.
Ważne jest jednak rozróżnienie dwóch sytuacji:
Planowana migracja
Możliwe jest przeniesienie działającej maszyny między hostami bez istotnej przerwy, jeśli platforma i konfiguracja to umożliwiają.
Nieplanowana awaria hosta
Najczęściej konieczne jest ponowne uruchomienie maszyny na innym serwerze, co oznacza pewien czas niedostępności.
HA nie zawsze zapewnia całkowicie nieprzerwaną pracę aplikacji. Zależy to od technologii i sposobu zaprojektowania samej aplikacji.
Dostępność 99,9% czy 99,99% – jaka jest różnica?
Różnica między poziomami dostępności może mieć duże znaczenie dla działalności przedsiębiorstwa. Poniższa tabela pokazuje szacunkowy maksymalny przestój w skali roku.
Dostępność | Maksymalny przestój roczny |
|---|---|
99% | około 3 dni i 15 godzin |
99,9% | około 8 godzin i 46 minut |
99,95% | około 4 godzin i 23 minut |
99,99% | około 52 minut i 34 sekund |
99,999% | około 5 minut i 15 sekund |
Wartości odnoszą się do roku liczącego 365 dni, przy ciągłym okresie świadczenia usługi. Sama redundancja infrastruktury nie gwarantuje osiągnięcia danego poziomu SLA — liczy się całość systemu, w tym aplikacje i procedury.
Najważniejsze elementy architektury High Availability
Redundancja serwerów
Podstawą wysokiej dostępności infrastruktury IT jest zapewnienie dodatkowych zasobów obliczeniowych, które mogą przejąć obciążenia po awarii jednego z hostów.
Liczba serwerów powinna wynikać z wymaganego poziomu odporności i dostępnej rezerwy mocy. W praktyce wykorzystuje się klastry dwu- i wielowęzłowe. Przy dwóch węzłach kluczowe są quorum oraz witness — bez nich łatwo o sytuację split-brain.
Wysoka dostępność pamięci masowej
Redundancja serwerów nie wystarcza, jeżeli wszystkie maszyny korzystają z pojedynczego, niezabezpieczonego zasobu dyskowego. Do rozważenia są m.in.:
- Macierze z redundantnymi kontrolerami.
- Sieci SAN z wieloma ścieżkami dostępu.
- Rozproszone systemy pamięci masowej i Software-Defined Storage.
- Replikacja pomiędzy lokalizacjami.
Wybór zależy od spójności danych, wydajności i opóźnień. Więcej o projektowaniu storage: obszar Storage.
Redundancja sieci
Niezależne interfejsy, przełączniki i ścieżki komunikacji ograniczają ryzyko pojedynczego punktu awarii. W środowiskach produkcyjnych warto rozdzielać ruch: zarządzający, migracyjny, storage i aplikacyjny.
Redundancja zasilania
Dwa zasilacze w serwerze nie zapewnią odporności, jeśli oba są podłączone do tego samego niezabezpieczonego źródła. Projekt powinien obejmować także PDU, UPS i pozostałe elementy toru zasilania.
Monitoring i automatyczne przełączanie
System HA musi rozpoznawać awarie i prawidłowo reagować na utratę komunikacji, hosta lub innych zasobów. Kluczowe są: monitoring klastra, quorum, fencing, kontrola split-brain, automatyczny failover oraz testowanie scenariuszy awaryjnych.
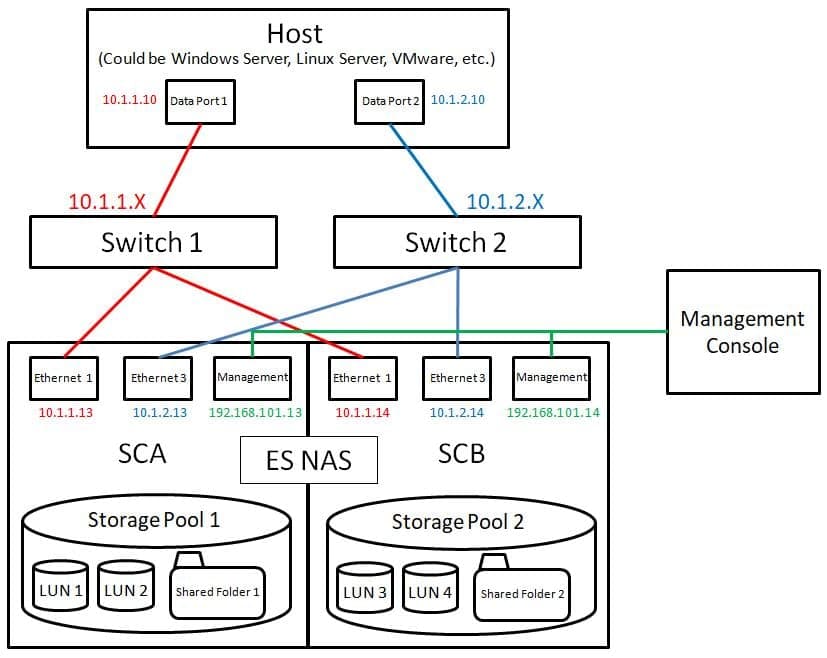
Schemat klastra wysokiej dostępności
Trzy hosty, redundantne sieci, pamięć masowa oraz mechanizmy quorum i failover. Schemat pokazuje zależności — HA działa tylko wtedy, gdy żaden krytyczny element nie jest pojedynczym punktem awarii.
VMware, Hyper-V czy Proxmox VE?
Nie istnieje jedna najlepsza platforma dla wszystkich organizacji. Wybór powinien uwzględniać wymagania aplikacji, koszty, kompetencje zespołu oraz strategię rozwoju infrastruktury.
VMware vSphere
VMware vSphere oferuje mechanizmy klastrowe, zarządzanie zasobami i funkcje wysokiej dostępności. W zależności od wersji i licencjonowania dostępne są migracje maszyn wirtualnych oraz automatyczne reagowanie na awarie hostów — klasyczny klaster VMware w wielu środowiskach enterprise.
Microsoft Hyper-V
Microsoft Hyper-V wraz z Windows Server Failover Clustering umożliwia budowanie klastrów wysokiej dostępności i Live Migration. Może współpracować z różnymi technologiami pamięci masowej oraz mechanizmami replikacji i ochrony danych.
Proxmox VE
Proxmox VE udostępnia funkcje HA, migracji maszyn wirtualnych i integracji z różnymi rozwiązaniami pamięci masowej, w tym Ceph. Stanowi alternatywę dla środowisk opartych na VMware i Hyper-V — Proxmox HA bywa wybierany tam, gdzie liczy się elastyczność licencyjna i otwarty ekosystem.
Szerszy kontekst wirtualizacji: obszar Wirtualizacja.
High Availability a Disaster Recovery
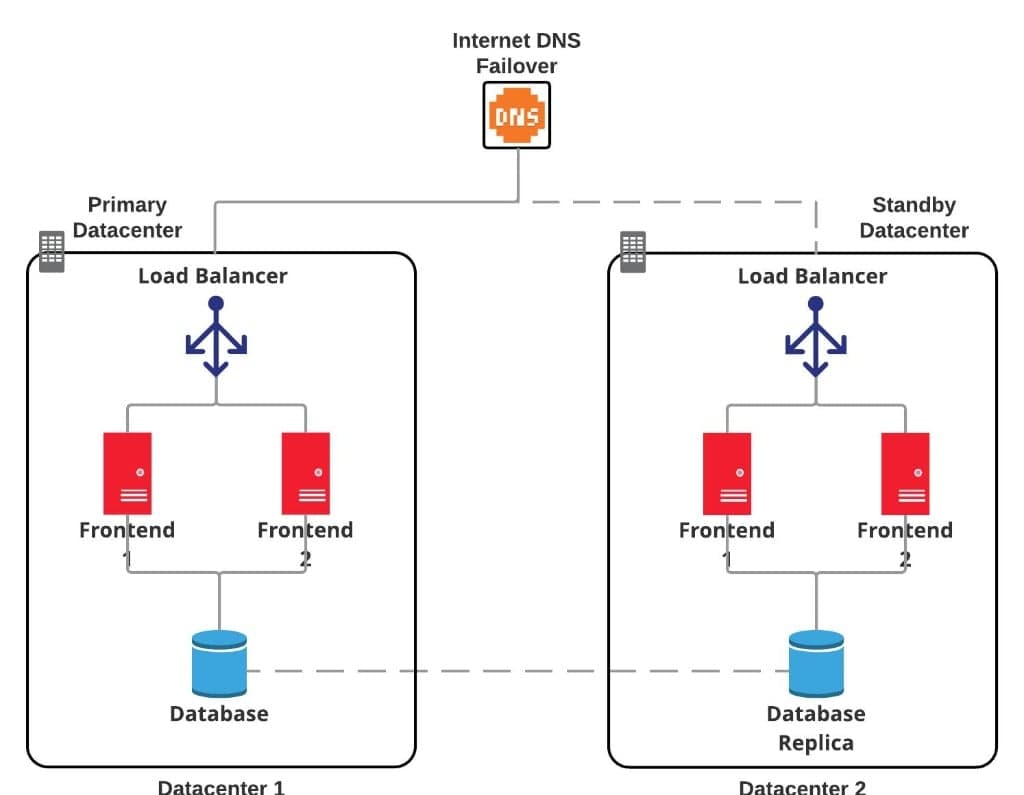
HA ogranicza skutki awarii w ramach lokalnego klastra. DR odtwarza usługi po utracie ośrodka podstawowego. Replikacja nie zastępuje backupu — błędne zmiany mogą trafić także do lokalizacji zapasowej.
High Availability a Disaster Recovery
High Availability oraz Disaster Recovery to dwa różne mechanizmy zapewniania ciągłości działania — nie należy ich mylić ani traktować zamiennie.
High Availability koncentruje się na ograniczaniu skutków awarii w ramach zaprojektowanego środowiska (np. lokalny klaster HA).
Disaster Recovery obejmuje przywrócenie usług po poważniejszym zdarzeniu, takim jak utrata całej lokalizacji lub rozległy incydent.
Organizacja może łączyć lokalny klaster HA z niezależnym ośrodkiem DR. HA nie zastępuje backupu. Replikacja maszyn wirtualnych również nie zastępuje backupu — błędne zmiany, usunięcia lub ransomware mogą zostać przeniesione do lokalizacji zapasowej.
Ochrona danych i odporność na zagrożenia: obszar Cyberbezpieczeństwo.
RPO i RTO – jak określić wymagania?
RPO – Recovery Point Objective — maksymalna akceptowalna utrata danych wyrażona w jednostkach czasu.
RTO – Recovery Time Objective — docelowy maksymalny czas przywrócenia usługi po zakłóceniu.
Przykładowo środowisko z RPO 15 minut i RTO 1 godzinę wymaga architektury pozwalającej odzyskać odpowiednio aktualne dane i przywrócić usługę w określonym terminie. Parametry te powinny wynikać z analizy biznesowej, a nie tylko z możliwości technicznych.
Najczęstsze błędy przy projektowaniu HA
- Brak rezerwy zasobów po awarii hosta — klaster nie utrzyma obciążenia po utracie węzła.
- Pojedyncze punkty awarii w sieci — wspólny switch lub uplink unieważnia redundancję serwerów.
- Niewłaściwa konfiguracja quorum — ryzyko split-brain lub niepotrzebnego zatrzymania usług.
- Brak poprawnych mechanizmów fencing — uszkodzony węzeł może nadal pisać do storage.
- Niezabezpieczona pamięć masowa — pojedyncza macierz lub ścieżka jako SPOF.
- Nieuwzględnienie zależności aplikacyjnych — failover hosta nie wystarczy, gdy baza lub kolejka są niedostępne.
- Brak testów przełączania awaryjnego — procedury istnieją tylko na papierze.
- Traktowanie HA jako zamiennika backupu — HA nie chroni przed logicznym uszkodzeniem danych.
- Niedoszacowanie opóźnień między lokalizacjami — synchroniczna replikacja wymaga odpowiedniego łącza.
Dostępność całej usługi może być niższa niż dostępność pojedynczych elementów infrastruktury — liczy się najsłabsze ogniwo łańcucha.
Jak zaplanować wdrożenie?
- 1. Inwentaryzacja — serwery, sieć, storage, aplikacje i zależności.
- 2. Analiza biznesowa — krytyczność systemów oraz RPO i RTO.
- 3. Projekt architektury — serwery, macierze, sieć, wirtualizacja i mechanizmy HA.
- 4. Wdrożenie — konfiguracja klastra, redundancji, monitoringu i zabezpieczeń.
- 5. Testy — symulacje awarii hosta, sieci, storage i innych komponentów.
- 6. Utrzymanie — aktualizacje, monitoring, okresowe testy i dokumentacja.
Podsumowanie
Wysoka dostępność to właściwość całego systemu, a nie pojedynczego urządzenia. Najlepsze rezultaty daje połączenie serwerów, sieci, storage, wirtualizacji i procedur operacyjnych.
Alterkom projektuje i wdraża infrastrukturę wysokiej dostępności, klastry wirtualizacyjne oraz rozwiązania backupu i Disaster Recovery.
Zacznij od przeglądu obszaru Infrastruktura IT albo skontaktuj się z zespołem.
Powiązane produkty z katalogu
Serwery i storage wykorzystywane w projektach wysokiej dostępności — dobór zawsze zależy od wymagań RPO/RTO i aplikacji.
Powiązane obszary działalności
Tematy powiązane z projektowaniem redundantnej infrastruktury IT.
Infrastruktura IT
Serwery, klastry i projektowanie środowisk produkcyjnych.
Zobacz obszar
Wirtualizacja
VMware, Hyper-V, Proxmox i klastry HA.
Zobacz obszar
Storage
Wysoka dostępność pamięci masowej i ścieżki multipath.
Zobacz obszar
Cyberbezpieczeństwo
Ochrona danych, backup i odporność na ransomware.
Zobacz obszarPrzeczytaj również
Inne materiały z działu Wiedza.
Zadbaj o ciągłość działania swojej infrastruktury IT
Pomożemy zaprojektować wydajne i wysoko dostępne środowisko serwerowe, dobrać platformę wirtualizacyjną oraz zaplanować backup i Disaster Recovery.
Polecane przez Alterkom
Rozwiązania, obszary i produkty powiązane z tematem artykułu — naturalna ścieżka do oferty.