Artificial intelligence / AI infrastructure · Draft
Dell GB10 and GB300 — English translation pending review
The Polish expert article is available as a draft. English copy will be published after editorial review — not auto-translated.
This page is a draft. Full Polish content is maintained in the PL locale. An English translation will be added after human review.
Polish article path: /wiedza/dell-gb10-gb300-lokalne-ai-vllm.
Dell Pro Max z GB10 — w skrócie
128 GB
Zunifikowana pamięć LPDDR5X
1 PFLOPS
Deklarowana wydajność AI FP4
273 GB/s
Przepustowość pamięci
do 200B*
Deklarowany limit parametrów modelu
Dell Pro Max z GB10 – lokalne centrum sztucznej inteligencji
Mały komputer, duże możliwości
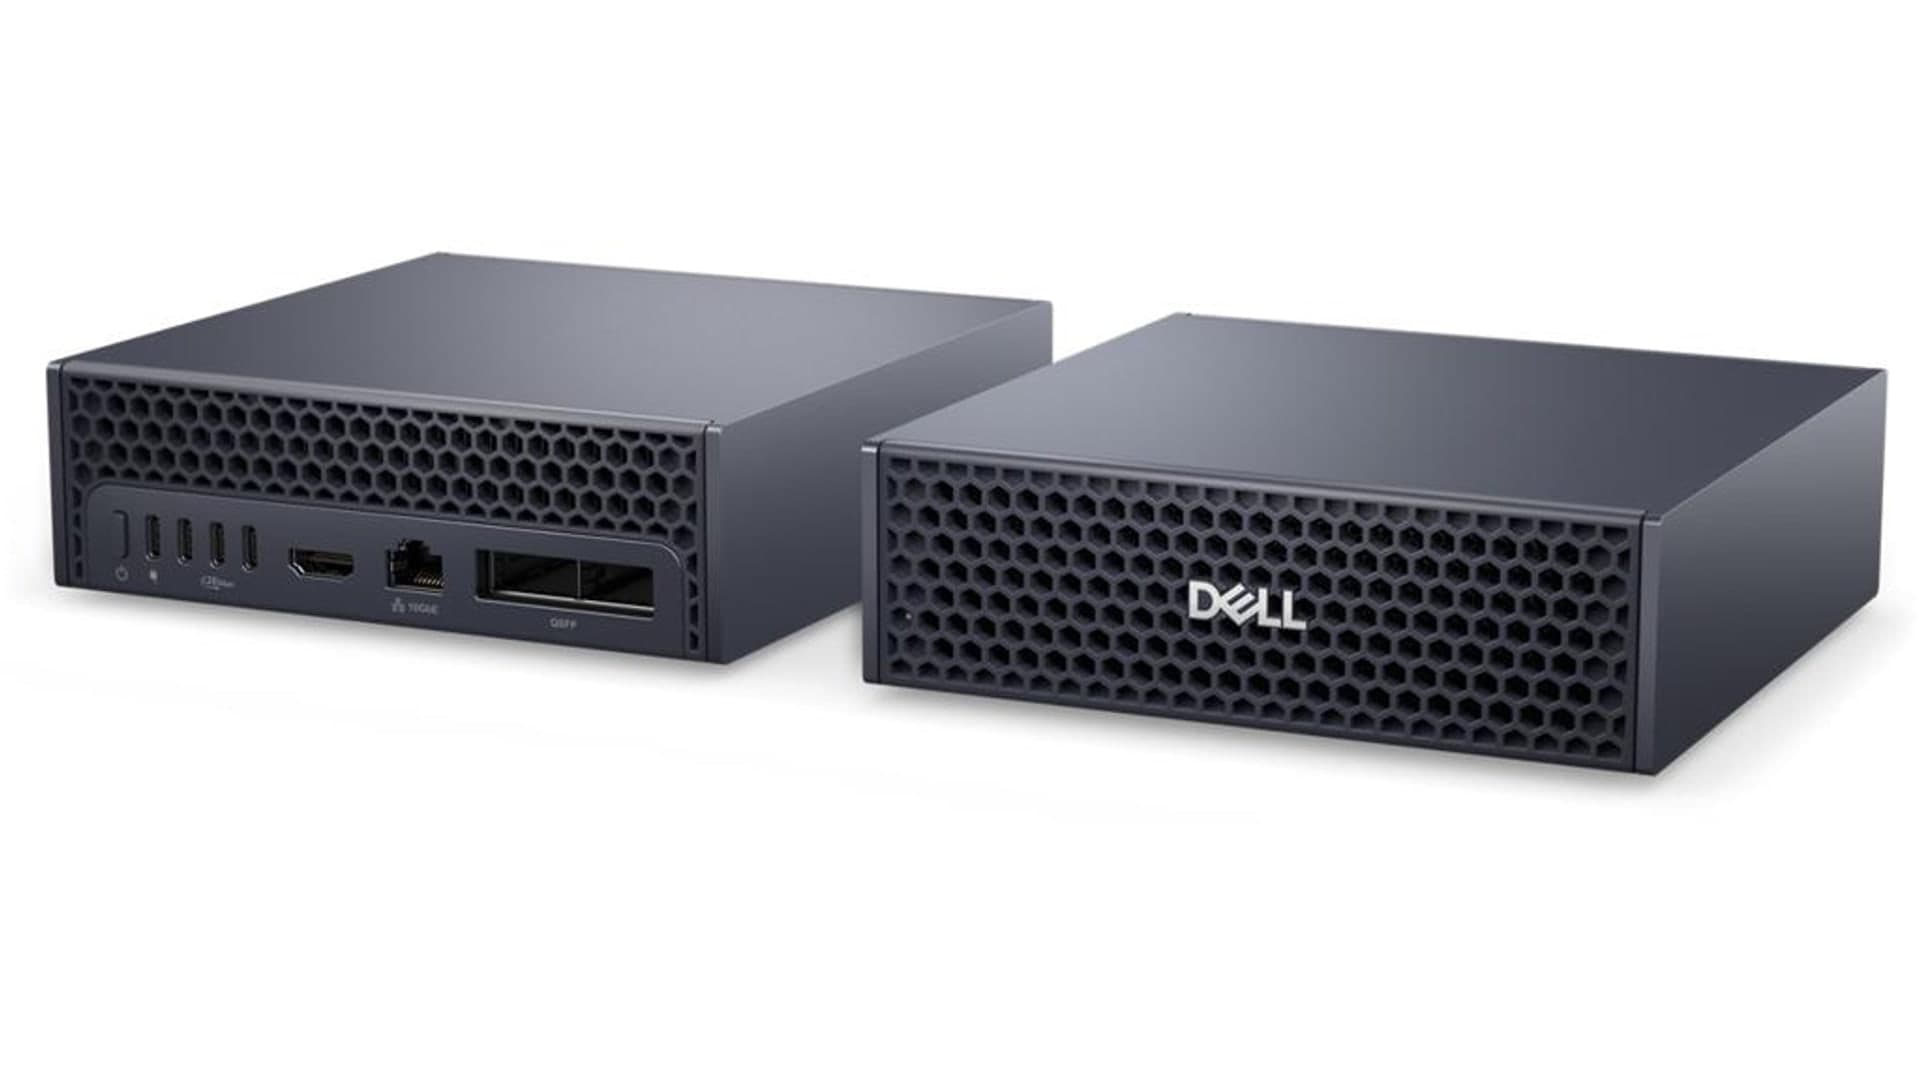
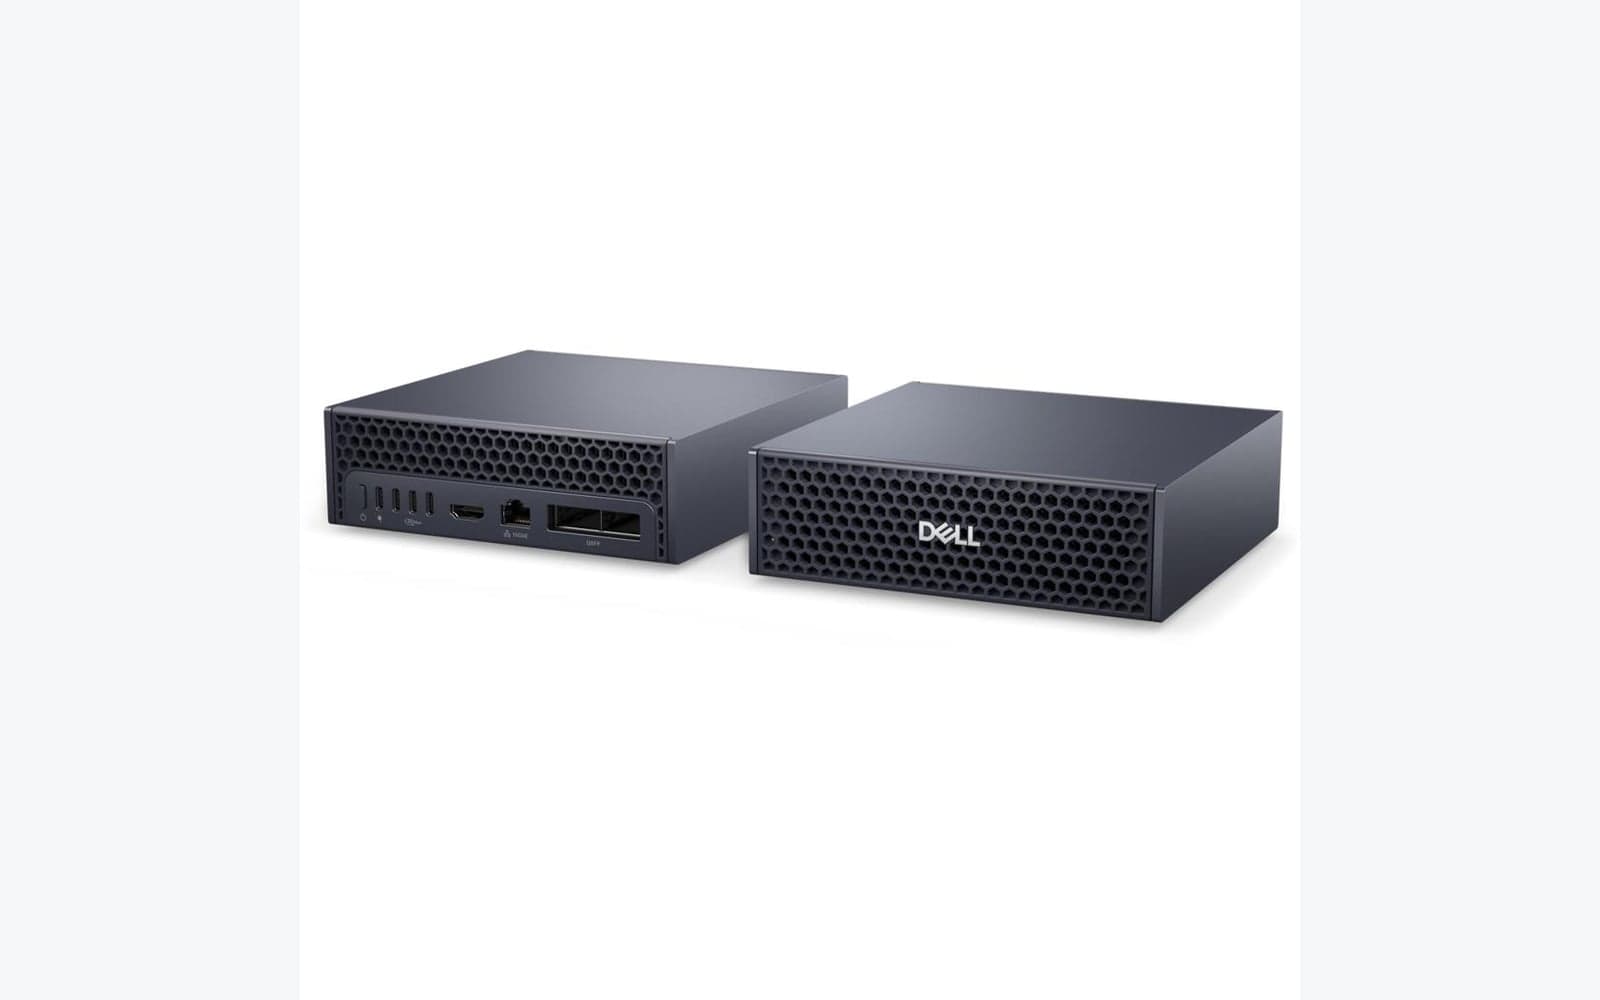
Dell Pro Max z GB10 jest niewielkim komputerem zaprojektowanym specjalnie do pracy ze sztuczną inteligencją. Jego sercem jest układ NVIDIA GB10 Grace Blackwell Superchip, który integruje procesor ARM, akcelerator GPU NVIDIA Blackwell oraz wspólny obszar pamięci.
Najważniejszą cechą tej konstrukcji jest 128 GB pamięci współdzielonej przez CPU i GPU. W klasycznej stacji roboczej karta graficzna dysponuje osobną pamięcią VRAM, której pojemność ogranicza wielkość możliwego do uruchomienia modelu. GB10 wykorzystuje jednolitą przestrzeń pamięci, dzięki czemu może obsługiwać modele znacznie większe niż typowa karta graficzna z 16 lub 24 GB VRAM.
Nie oznacza to jednak, że GB10 dorównuje wydajnością serwerowym akceleratorom NVIDIA H100, H200 czy B300. Jego przewagą jest połączenie dużej dostępnej pamięci, stosunkowo niewielkiego poboru energii i kompaktowych rozmiarów.
NVIDIA GB10 Grace Blackwell Superchip
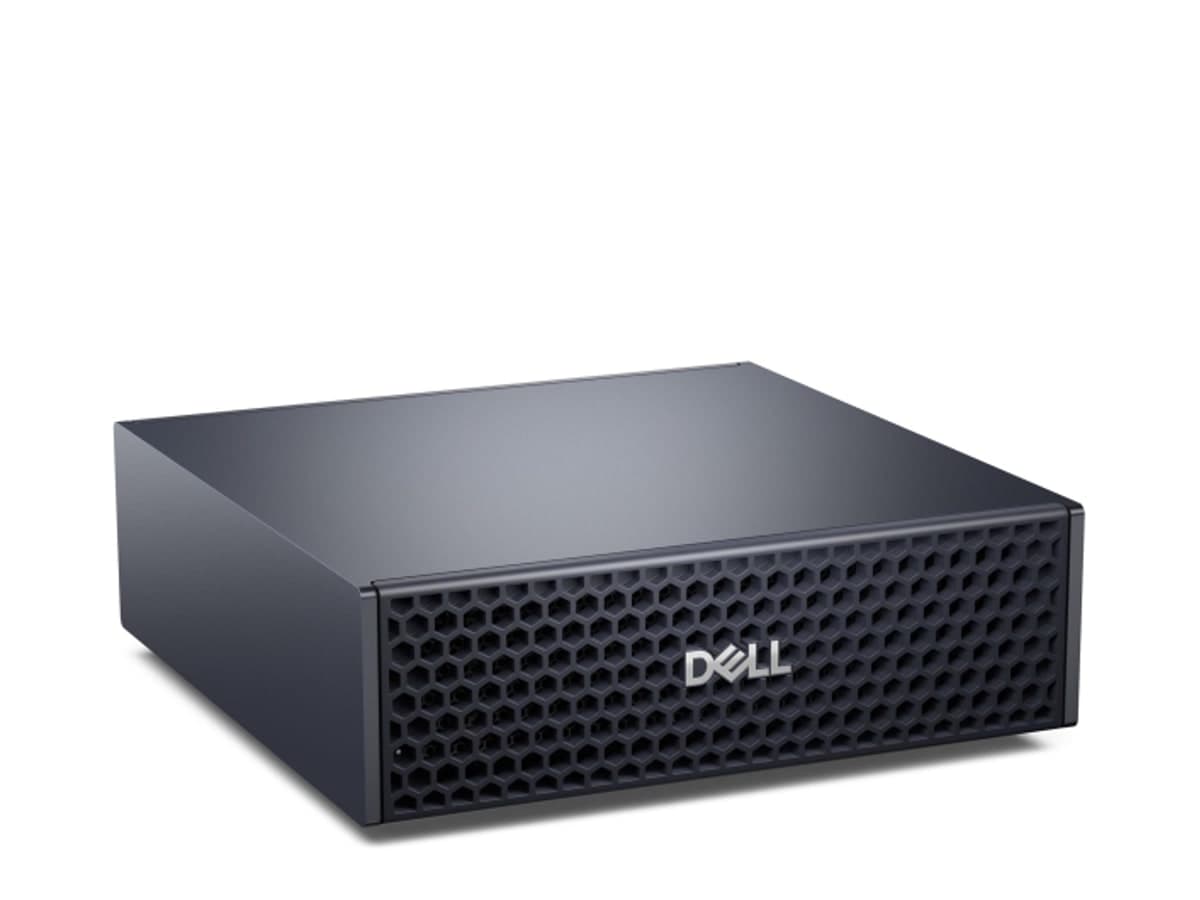
Kompaktowa obudowa Dell Pro Max z GB10 łączy CPU ARM, GPU Blackwell i 128 GB pamięci współdzielonej — lokalne LLM bez serwerowni.
Dokładna specyfikacja Dell GB10
Szczegóły obudowy, nośników i portów należy zweryfikować dla wybranej konfiguracji Dell.
| Komponent | Specyfikacja |
|---|---|
| Układ | NVIDIA GB10 Grace Blackwell Superchip |
| Procesor CPU | 20 rdzeni ARM: 10 × Cortex-X925 i 10 × Cortex-A725 |
| Architektura | ARM64 / NVIDIA Grace Blackwell |
| GPU | NVIDIA Blackwell, 6144 rdzenie CUDA |
| Jednostki Tensor | 5. generacja, obsługa FP4 / NVFP4 |
| Wydajność AI | Do 1 PFLOPS FP4 z wykorzystaniem sparsity |
| Pamięć | 128 GB LPDDR5X, zunifikowana |
| Przepustowość pamięci | 273 GB/s |
| Pamięć masowa | SSD M.2 NVMe PCIe 4.0, warianty 1–4 TB |
| Sieć | 10 GbE, NVIDIA ConnectX-7 |
| Łączność bezprzewodowa | Wi-Fi 7, Bluetooth |
| Połączenia wysokiej przepustowości | QSFP / ConnectX-7, do 200 Gb/s na port |
| System operacyjny | NVIDIA DGX OS, oparty na Ubuntu Linux |
| Środowisko | CUDA, Docker, NVIDIA AI, PyTorch, vLLM |
| Zasilanie | Zewnętrzny zasilacz 240 W |
| TDP układu GB10 | 140 W |
| Wymiary platformy referencyjnej | Około 150 × 150 × 50,5 mm |
| Przeznaczenie | AI development, inference, fine-tuning, edge AI |
Specyfikację GB10 potwierdzają materiały Dell i dokumentacja referencyjna NVIDIA. Szczegóły obudowy, nośników i portów należy każdorazowo zweryfikować dla wybranej konfiguracji Dell.
Limit 200 miliardów parametrów jest deklarowaną przez producenta możliwościową granicą platformy, zależną od kwantyzacji, długości kontekstu i konfiguracji uruchomieniowej. Nie oznacza jednakowej wydajności dla wszystkich takich modeli.
Co można rzeczywiście uruchomić na GB10?
Najciekawsze możliwości GB10 ujawniają się po uruchomieniu własnego serwera inferencyjnego. Zamiast wysyłać zapytania do publicznego API, przedsiębiorstwo może udostępniać swoje modele przez wewnętrzną sieć.
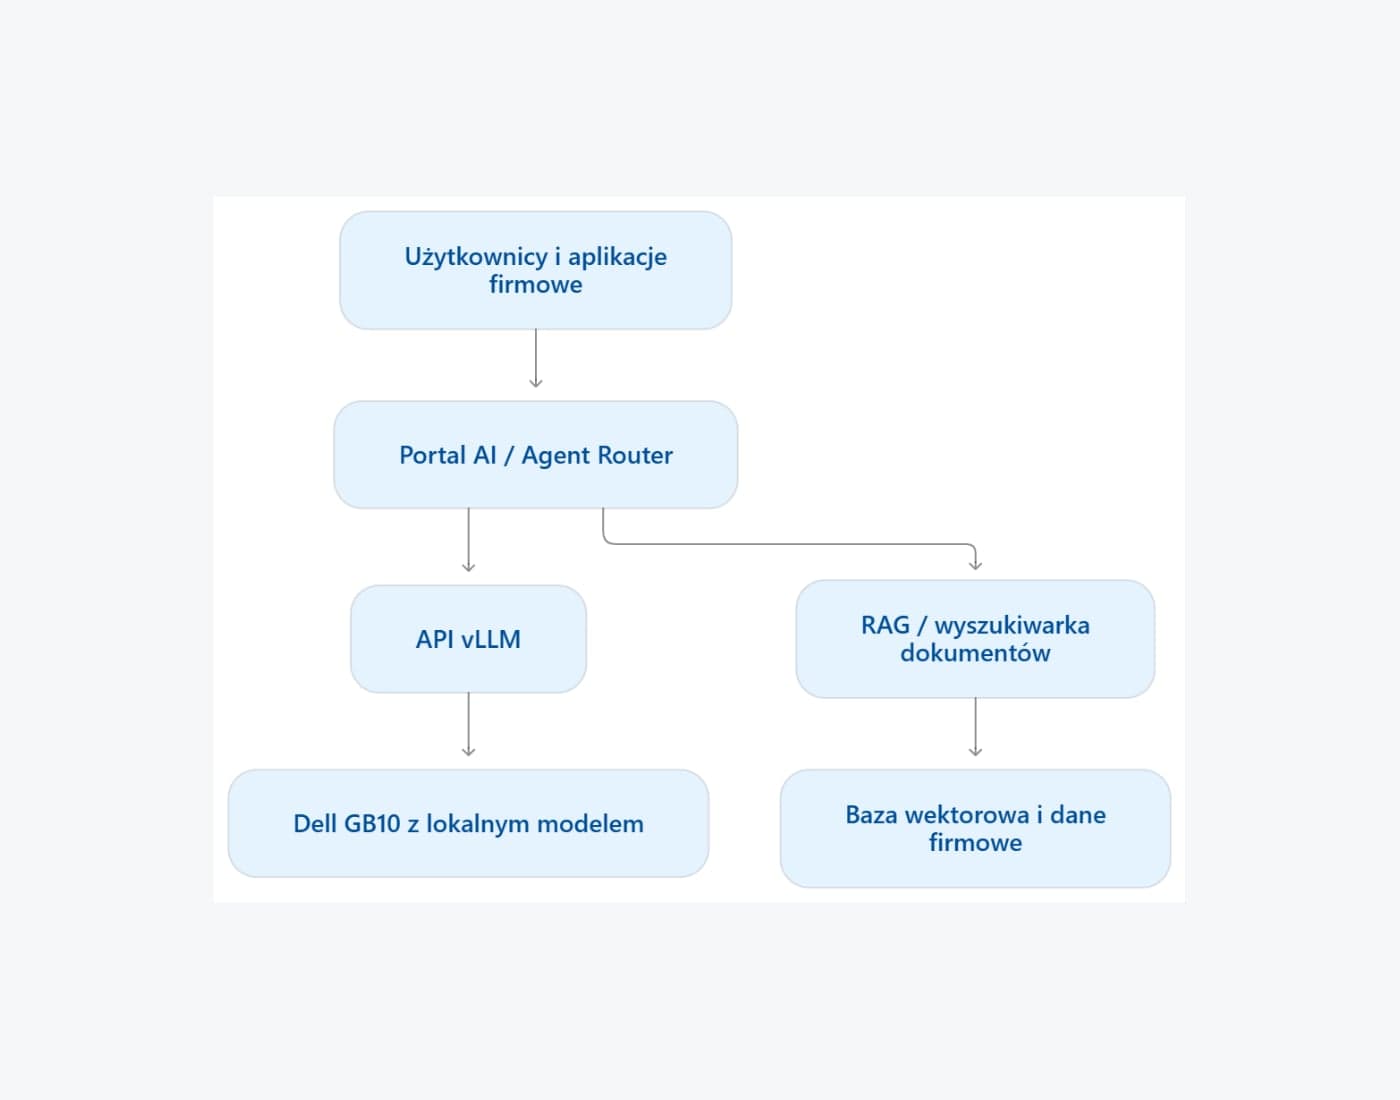
Przykładowa architektura firmowej usługi AI z vLLM
GB10 może stanowić silnik inferencyjny dla firmowych portali, chatbotów i agentów AI. Pozostałe usługi mogą działać na tym samym urządzeniu lub na osobnych serwerach.
Schemat referencyjny — w produkcji warstwy można rozdzielić na osobne hosty i dodać HA.
1. Lokalne modele językowe LLM
Na GB10 można uruchamiać modele generujące i analizujące tekst, rozumiejące instrukcje oraz wspierające pracę z dokumentami i kodem.
Przykładowe rodziny modeli:
- Llama 3.1 8B — szybkie chatboty, analiza tekstu i aplikacje RAG
- Qwen 3 8B / 32B — asystenci, programowanie, zadania wielojęzyczne
- Mistral Small — asystenci firmowi, przetwarzanie dokumentów
- DeepSeek-R1-Distill — rozumowanie, zadania analityczne i programowanie
- GPT-OSS 20B — agenci AI, narzędzia i rozumowanie
- GPT-OSS 120B — duży model MoE, możliwy do lokalnej inferencji w odpowiedniej reprezentacji MXFP4
W praktyce modele klasy 7B–32B są naturalnym punktem startowym dla GB10. Zapewniają korzystny kompromis między wielkością, możliwościami i czasem odpowiedzi. Modele 70B i 120B wymagają starannego doboru formatu wag, kontekstu i parametrów inferencji.
Przykładowo GPT-OSS 120B wykorzystuje architekturę Mixture of Experts (MoE), w której przy generowaniu tokenu aktywowana jest tylko część parametrów. Dzięki temu jego wymagania obliczeniowe są inne niż w klasycznym, gęstym modelu o podobnej liczbie parametrów.
2. vLLM – własny serwer API zgodny z OpenAI
Jednym z najważniejszych zastosowań GB10 jest uruchamianie vLLM.
vLLM jest silnikiem udostępniającym modele językowe przez API. Obsługuje między innymi:
- Dynamiczne grupowanie zapytań (continuous batching).
- Efektywne zarządzanie pamięcią KV cache.
- Równoległą obsługę użytkowników.
- Modele o różnych formatach precyzji i kwantyzacji.
- Streaming odpowiedzi.
- Endpointy kompatybilne z API OpenAI.
- Integrację z portalami, aplikacjami i systemami agentowymi.
Przykładowo aplikacja może wysyłać zapytanie na wewnętrzny adres https://ai.firma.pl/v1/chat/completions, a vLLM przetworzy je lokalnie.
Dell opublikował również testy GB10 z vLLM i NVIDIA NIM, obejmujące różne długości kontekstu i poziomy współbieżności. W jednym z testów wykorzystanie modelu Llama 3.1 8B w formacie NVFP4 pozwoliło uzyskać znacznie większą przepustowość niż porównywane konfiguracje FP8/INT4. Wyniki potwierdzają, że odpowiedni dobór kwantyzacji i silnika inferencyjnego ma duży wpływ na praktyczną wydajność.
Dokumentacja Dell: Dell Pro Max GB10 – deploying LLMs.
3. RAG – sztuczna inteligencja korzystająca z dokumentów firmy
GB10 dobrze nadaje się do budowy rozwiązań Retrieval-Augmented Generation (RAG).
Pozwalają one połączyć model językowy z firmowymi zasobami, takimi jak:
- dokumentacja techniczna i instrukcje;
- umowy, regulaminy i procedury;
- oferty handlowe i specyfikacje produktów;
- bazy wiedzy działów wsparcia;
- dokumentacja projektowa oraz zgłoszenia serwisowe.
Model nie musi posiadać całej wiedzy w swoich parametrach. Odpowiednie fragmenty dokumentów są wyszukiwane i dołączane do zapytania, co pozwala przygotowywać odpowiedzi na podstawie aktualnych informacji.
W takim środowisku GB10 może obsługiwać model LLM, podczas gdy wyszukiwarka semantyczna, baza wektorowa i system zarządzania dokumentami działają na osobnych usługach.
4. Agenci AI i automatyzacja procesów
GB10 może również pełnić rolę lokalnego silnika dla agentów AI, którzy nie tylko odpowiadają na pytania, ale wykonują zadania z użyciem narzędzi.
Przykłady zastosowań:
- Analizowanie dokumentacji postępowania zakupowego.
- Wyszukiwanie produktów zgodnych z wymaganiami technicznymi.
- Przygotowywanie projektów odpowiedzi na zapytania klientów.
- Analiza logów infrastruktury IT.
- Generowanie raportów i podsumowań.
- Integracja z CRM, ERP oraz bazami SQL.
- Obsługa wewnętrznych chatbotów pracowniczych.
W rozwiązaniach Alterkom tego rodzaju platforma może współpracować z Agent Router, Hermes Agent oraz portalami korzystającymi z modeli AI.
5. Fine-tuning i dostosowywanie modeli
GB10 pozwala również eksperymentować z dostrajaniem modeli do specjalistycznych zadań.
Szczególnie interesujące są metody LoRA i QLoRA, które umożliwiają dostrajanie ograniczonego zestawu parametrów bez konieczności pełnego trenowania wszystkich wag modelu.
Pozwala to tworzyć modele lepiej dostosowane do terminologii branżowej, struktury firmowych dokumentów lub specyficznych formatów odpowiedzi.
Pełny trening bardzo dużego modelu od podstaw pozostaje jednak poza praktycznym zakresem pojedynczego GB10.
Ograniczenia GB10 – dlaczego 128 GB pamięci to nie wszystko?
Podczas wyboru sprzętu AI łatwo skupić się na deklarowanej liczbie parametrów obsługiwanego modelu. Tymczasem wydajność zależy również od przepustowości pamięci, charakterystyki GPU i obciążenia.
GB10 oferuje 273 GB/s przepustowości zunifikowanej pamięci. To dużo jak na kompaktowy komputer, ale znacznie mniej niż przepustowość pamięci HBM3e stosowanej w dużych akceleratorach AI.
Konsekwencje są następujące:
- Duże modele mogą mieścić się w pamięci, ale generować odpowiedzi relatywnie wolno.
- Długie konteksty zwiększają zużycie pamięci KV cache.
- Wysoka współbieżność użytkowników może istotnie zwiększać opóźnienia.
- Jednoczesne uruchamianie wielu dużych modeli ogranicza dostępne zasoby.
- Zastosowania produkcyjne o wymaganym SLA mogą potrzebować dodatkowych węzłów i mechanizmów wysokiej dostępności.
GB10 jest więc bardzo interesującą platformą do rozwoju, testowania i lokalnego wdrażania AI, ale nie zastępuje infrastruktury serwerowej we wszystkich scenariuszach.
Dell GB300 – osobisty superkomputer do zaawansowanej AI
Materiały Dell: Dell Pro Max z NVIDIA AI.
O ile GB10 pozwala rozpocząć pracę z lokalną sztuczną inteligencją, o tyle GB300 otwiera możliwości dotychczas kojarzone głównie z profesjonalnymi serwerami GPU.
Dell Pro Max z GB300, obecnie występujący również pod nazwą Dell Pro Precision z GB300, wykorzystuje NVIDIA Grace Blackwell Ultra Desktop Superchip.
Urządzenie łączy 72-rdzeniowy procesor NVIDIA Grace z akceleratorem Blackwell Ultra i bardzo dużą ilością pamięci.
Dell GB300 — w skrócie
20 PFLOPS
Deklarowana moc FP4*
748 GB
Pamięć koherentna łącznie
252 GB
HBM3e (GPU)
do 1T*
Deklarowany limit parametrów
Dell Pro Max / Pro Precision z NVIDIA GB300
Profesjonalna stacja tower z Grace Blackwell Ultra: 252 GB HBM3e, do 7,1 TB/s przepustowości GPU oraz 496 GB LPDDR5X po stronie CPU — duże LLM, multi-agent i zaawansowana inferencja lokalnie.
Specyfikacja techniczna Dell GB300
| Komponent | Specyfikacja |
|---|---|
| Układ | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip |
| Procesor | NVIDIA Grace, 72 rdzenie ARM Neoverse V2 |
| GPU | NVIDIA Blackwell Ultra B300 |
| Wydajność AI | Do 20 PFLOPS FP4 z sparsity |
| Pamięć GPU | 252 GB HBM3e |
| Przepustowość pamięci GPU | Do 7,1 TB/s (7100 GB/s) |
| Pamięć CPU | 496 GB LPDDR5X |
| Przepustowość pamięci CPU | Do 396 GB/s |
| Łączna pamięć koherentna | 748 GB |
| Połączenie CPU–GPU | NVIDIA NVLink-C2C |
| Sieć wysokiej przepustowości | NVIDIA ConnectX-8, do 800 Gb/s łącznie |
| Porty sieciowe | 2 × QSFP112 400 Gb/s, 10 GbE, 1 GbE |
| Pamięć masowa | Do 16 TB NVMe SSD w konfiguracji Dell |
| System | Ubuntu 24.04 LTS, NVIDIA AI Developer Tools |
| Dodatkowy układ graficzny | Zależnie od konfiguracji, np. RTX PRO do obsługi obrazu |
| Obudowa Dell | Stacja typu tower |
| Zastosowanie | Duże LLM, zaawansowana inferencja, fine-tuning, multi-agent AI, badania |
Pamięć HBM3e jest zdecydowanie szybsza niż zunifikowana pamięć LPDDR5X w GB10. Dodatkowe 496 GB pamięci procesora pozostaje dostępne poprzez spójny model pamięci CPU–GPU, ale nie ma takiej samej charakterystyki wydajnościowej jak lokalna HBM GPU.
Co umożliwia GB300?
Obsługa największych modeli AI
GB300 pozwala uruchamiać znacznie większe modele niż GB10. Producent deklaruje obsługę modeli sięgających biliona parametrów, pod warunkiem odpowiedniego formatu wag i konfiguracji.
W praktyce interesujące są między innymi:
- GPT-OSS 120B – szybka inferencja dużego modelu MoE.
- DeepSeek-R1 671B – bardzo duży model rozumujący, wymagający odpowiedniej kwantyzacji i zarządzania pamięcią.
- Qwen 235B i większe warianty MoE – złożone zadania językowe, analiza, kod i agenci.
- Duże modele multimodalne – wspólna analiza tekstu, obrazów i innych danych.
- Wyspecjalizowane modele programistyczne, analityczne i naukowe.
NVIDIA wskazuje wprost na możliwość uruchamiania dużych modeli lokalnie, ale trzeba pamiętać, że obsługa modelu o bilionie parametrów nie oznacza automatycznie najwyższej przepustowości ani możliwości trenowania go od podstaw na jednej stacji.
Zaawansowana inferencja z vLLM
GB300 jest szczególnie atrakcyjny dla środowisk wykorzystujących vLLM, SGLang oraz NVIDIA TensorRT-LLM.
Duża pamięć HBM3e umożliwia utrzymywanie większej części wag i buforów roboczych bezpośrednio na GPU, co ogranicza wąskie gardła charakterystyczne dla mniejszych platform.
Pozwala to budować usługi, które wymagają:
- Większej liczby jednoczesnych zapytań.
- Obsługi długich kontekstów.
- Uruchamiania kilku modeli równolegle.
- Zaawansowanego rozumowania AI.
- Rozbudowanych aplikacji RAG.
- Przetwarzania dokumentów i danych multimodalnych.
Wieloagentowe systemy AI
Jednym z najbardziej przyszłościowych zastosowań GB300 jest obsługa środowisk multi-agent, w których wiele modeli i agentów współpracuje nad jednym procesem.
Przykładowo system może zawierać:
- Agenta analizującego wymagania klienta.
- Agenta wyszukującego informacje i dokumentację.
- Agenta analizującego produkty oraz dane techniczne.
- Agenta generującego ofertę lub raport.
- Agenta kontrolującego poprawność przygotowanej odpowiedzi.
Duża ilość pamięci i wysoka przepustowość pozwalają ograniczyć konieczność ciągłego przeładowywania modeli oraz efektywniej obsługiwać równoległe zadania. Rzeczywista liczba agentów zależy jednak od ich modeli, częstotliwości pracy i długości kontekstu.
Dostrajanie i rozwój własnych modeli
GB300 nadaje się również do poważniejszych zadań uczenia maszynowego.
Poza LoRA i QLoRA możliwe jest wykorzystanie pełniejszego dostrajania modeli tam, gdzie pozwalają na to zasoby pamięci i wymagania optymalizatora.
Platforma może służyć do:
- Tworzenia modeli wyspecjalizowanych branżowo.
- Trenowania adapterów dla dużych modeli językowych.
- Eksperymentów z modelami multimodalnymi.
- Prac badawczych nad architekturami AI.
- Testowania nowych algorytmów inferencji.
- Przygotowywania modeli do wdrożenia na klastrach GPU.
GB300 jest zatem rozwiązaniem pozwalającym prowadzić zaawansowany rozwój sztucznej inteligencji lokalnie, choć trening największych modeli bazowych od zera nadal wymaga wielowęzłowych systemów obliczeniowych.
GB10 czy GB300? Porównanie możliwości
Wartości FP4 są teoretycznymi wartościami szczytowymi przy określonych warunkach. Stosunek 20:1 nie oznacza, że GB300 będzie dokładnie dwadzieścia razy szybszy w każdym zadaniu.
| Parametr | Dell GB10 | Dell GB300 |
|---|---|---|
| Główne zastosowanie | Rozwój i lokalne wdrożenia AI | Zaawansowane AI i duże obciążenia |
| CPU | 20 rdzeni ARM | 72 rdzenie ARM |
| Wydajność FP4* | Do 1 PFLOPS | Do 20 PFLOPS |
| Pamięć | 128 GB zunifikowanej LPDDR5X | 252 GB HBM3e + 496 GB LPDDR5X |
| Przepustowość pamięci GPU / współdzielonej | 273 GB/s | 7,1 TB/s HBM3e |
| Deklarowana wielkość modelu | Do 200B | Do 1T |
| vLLM | Tak | Tak |
| RAG | Tak | Tak |
| Agenci AI | Tak, mniejsza skala | Tak, duża skala |
| Fine-tuning | Głównie metody oszczędzające pamięć | Większe modele i szerszy zakres metod |
| Intensywna inferencja | Ograniczona przez przepustowość i zasoby | Znacznie większy potencjał |
| Typ urządzenia | Kompaktowy desktop | Profesjonalna stacja tower |
| Optymalny odbiorca | Programista, dział IT, mały zespół AI | Zespół badawczy, duża firma, centrum rozwoju AI |
Różnica w przepustowości pamięci wykorzystywanej do obliczeń AI
Wartości nominalne w GB/s. HBM3e GB300 jest pamięcią lokalną GPU, a LPDDR5X GB10 pamięcią współdzieloną.
- GB10 LPDDR5X273 GB/s
- GB300 HBM3e7100 GB/s
HBM3e w GB300 oferuje około 26 razy większą nominalną przepustowość niż pamięć LPDDR5X w GB10. To jeden z najważniejszych czynników w inferencji dużych modeli. Deklarowana wydajność FP4 nie jest bezpośrednim odpowiednikiem rzeczywistej szybkości generowania tokenów.
Porównanie deklarowanej wydajności FP4
Wartości szczytowe ze sparsity — nie bezpośrednio token/s.
- GB101 PFLOPS
- GB30020 PFLOPS
Stosunek 20:1 nie oznacza, że GB300 jest zawsze dwadzieścia razy szybszy w każdym zadaniu inferencji. Typy pamięci i charakterystyka obciążenia mają kluczowe znaczenie.
Które rozwiązanie wybrać?
Dell GB10 będzie odpowiednim rozwiązaniem dla organizacji, które chcą stworzyć własne środowisko AI, wdrażać lokalne modele, przetwarzać dokumenty i rozwijać aplikacje oparte na vLLM. Jego zaletami są niewielkie rozmiary, duża pamięć jak na komputer biurkowy oraz możliwość korzystania z profesjonalnego ekosystemu NVIDIA.
Dell GB300 jest przeznaczony dla organizacji, które wymagają znacznie większej wydajności i chcą lokalnie pracować z modelami liczącymi setki miliardów parametrów. Sprawdza się w zaawansowanych środowiskach badawczych, systemach wieloagentowych, inferencji dużych modeli oraz dostrajaniu AI.
Warto jednak zaznaczyć, że pojedynczy GB300 nie jest odpowiednikiem całej serwerowni AI. Jeżeli celem jest świadczenie usług dla bardzo dużej liczby użytkowników, trenowanie modeli bazowych lub budowa wysokodostępnej platformy produkcyjnej, kolejnym krokiem są wielowęzłowe systemy GPU, takie jak NVIDIA GB300 NVL72 i infrastruktura Dell AI Factory.
Alterkom – od koncepcji do własnej infrastruktury AI
Technologia jest tylko jednym z elementów skutecznego wdrożenia sztucznej inteligencji. Równie ważne pozostają dobór modeli, przygotowanie danych, bezpieczeństwo, integracja z systemami informatycznymi oraz kontrola jakości odpowiedzi.
Alterkom wspiera organizacje w projektowaniu i wdrażaniu lokalnych środowisk AI – od kompaktowych stacji roboczych po rozbudowane rozwiązania serwerowe.
W ramach projektów możliwe jest połączenie sprzętu Dell Technologies z silnikami inferencyjnymi vLLM, systemami RAG, modelami open-weight oraz agentami AI korzystającymi z firmowych narzędzi i baz danych.
Celem nie jest wyłącznie uruchomienie modelu językowego, ale stworzenie rozwiązania, które rzeczywiście usprawnia procesy biznesowe i pozostaje pod kontrolą organizacji.
Lokalne AI przestaje być wyłącznie środowiskiem eksperymentalnym. Dzięki platformom takim jak Dell GB10 i GB300 może stać się integralnym elementem infrastruktury informatycznej przedsiębiorstwa.
Materiały źródłowe
Artykuł opracowano na podstawie dokumentacji producentów i materiałów technicznych:
• Dell – komputery Pro Max z GB10 i GB300
• Dell – wdrażanie modeli LLM na GB10, testy vLLM
Powiązane produkty w katalogu
Kompaktowe platformy AI i serwery wykorzystywane w projektach lokalnego AI.
Dowiedz się więcej
Powiązane treści Alterkom — lokalne AI, produkty i obszary.
Lokalne AI w firmie – wdrożenie
Private AI, lokalne modele LLM, serwery GPU, RAG i bezpieczeństwo danych — krok po kroku.
Czytaj więcej
Rozwiązania AI Alterkom
Lokalne modele, GPU i Private AI w infrastrukturze przedsiębiorstwa.
Zobacz obszar
Alterkom ChatBot
Firmowy asystent AI oparty o lokalne modele i kontrolę nad danymi.
Zobacz produkt
Wysoka dostępność serwerów
Klastry HA, redundancyjne ścieżki i Disaster Recovery.
Czytaj więcejZbuduj własną infrastrukturę AI z Alterkom
Dobór infrastruktury Dell Technologies · Instalacja i konfiguracja lokalnych LLM · vLLM i API · RAG · Integracje z systemami firmowymi · Agenci AI i automatyzacja procesów.
Recommended by Alterkom
Solutions, focus areas and products related to this article — a path into our offer.